面倒なことはChatGPTにやらせよう
(書評というか感想です)
TL;DR
- ChatGPTを使うビジネスマンは絶対買いましょう
- ChatGPTを使ってる人は買って損ないです
- LLMなどの研究者は別に買わなくていいかも
- でも知り合いに買ってあげたい....!!って感じる本なので買いましょう
はじめに
縁があって、人生初の献本を頂いたので、書評というものを書いてみようと思います。
「面倒なことはChatGPTにやらせよう」を講談社様からご献本頂きました!
— おじろ (@ozro_223) 2024年1月26日
自分も知らないことが結構ありました笑
CH11とかは営業職の知り合いが知りたがっていた所が書いてて良きでした!
詳しい感想などは後日ブログで書きます!
カレーさん、からあげさんありがとうございます!! pic.twitter.com/9ggNYoj4du
自分みたいな一般ピーポーが献本を頂いたのは、この本を書くための恋のキューピット的な役割を果たしたからだと思います(ツイート・リプはしてみるもんだな〜と改めて思いますね)
恋のキューピットみたいな仕事してしまったな。楽しみだ〜 pic.twitter.com/AktfVX0Jqr
— おじろ (@ozro_223) 2023年9月8日
今回は「面倒なことはChatGPTにやらせよう」という本について書きます!!
名前は「退屈なことはPythonにやらせよう」を参考にしてそうですね。PythonからChatGPTと時代の流れを勝手に感じてます。
巷にはChatGPTの本がたくさんありますが、やはり差別化されるところとしては、カレーさん、からあげさんというつよつよエンジニアが書いているというところでしょうかね。
やはりお二人が書いたものなので、内容もクオリティ高く、尚且つChatGPTなどのシステムに慣れていない方でもわかりやすい構成になっていました。
内容
以下はAmazonから引用した目次です。
第1部でChatGPTについての基本的な説明、第2部から応用的な話になっています。
- 第1部 知っておきたいChatGPTの基本
- 1章 ChatGPTの基礎知識
- 2章 ChatGPTの基本的な使い方
- 3章 ChatGPT Plusのセットアップ
- 4章 ファイルのアップロードとダウンロード
- 第2部 ChatGPTが使える日常テクニック
- 5章 繰り返し作業を一瞬で
- 6章 画像の多彩な加工・生成
- 7章 手軽に音声ファイル処理
- 8章 丸投げ! PowerPointスライド作成
- 9章 マニュアル不要でExcel操作
- 10章 WordファイルとPDFファイルの便利技
- 第3部 ChatGPTでのデータサイエンス
- 11章 データからかんたんグラフ作成
- 12章 データからビジネスに役立つヒントを得る
- 第4部 ChatGPTのさらに便利な応用テクニック
- 13章 業務を効率化する
- 14章 ゲームで遊ぶ
- 15章 ブラウザアプリを作る
- 16章 PythonをChatGPTと勉強する
- 17章 アドバンスな活用法にチャレンジ
感想
まず、絵が可愛いです。ライスくんとチキン姉さんが可愛く描かれています(著者含めて食べ物の名前で溢れている)。
また、サポートページがNotionで作られており、見やすいです。本に載っているプロンプトなどもコピーできて便利です。
以下感想です(箇条書きで許してください)
- 第1部
- 基本的なChatGPTやChatGPT Plusの使い方が載ってます。
- プロンプトの悪い例と良い例が載っているのですが、良い例の言い回しが上手くて参考になります。著者の日本語能力を感じます。
- 第2部
- 第3部
- ChatGPTにグラフを書かせると日本語が文字化けしてしまうことがあり、初心者の方が解決するには難しい問題です。そこの解決方法などを紹介しています。
- japanize-matplotlibを使って文字化けを防ぐなど、ゴリゴリのことをしている。手順どうりやれば誰でもできますし、プロンプトはコピペでOK。
- グラフ化の話だったり、ビジネスへの応用など、ビジネスマンが欲しそうなことがすべて載っています。
- コードも載っているが、とりあえずChatGPTにコピペして渡せば良い(環境構築などが一切必要ない)のが良いですね。
- ChatGPTにグラフを書かせると日本語が文字化けしてしまうことがあり、初心者の方が解決するには難しい問題です。そこの解決方法などを紹介しています。
- 第4部
- ChatGPTの応用事例としてブラウザアプリを一緒に作ったり、一緒にプログラミングの勉強などをしています。
- 可能性は無限大だと改めて感じました。
おわりに
営業職の親戚が「ChatGPTでグラフを描きたくて〜」と頻繁に相談をしてきていましたが、この一冊で全て完結しそうな感じがしました。
とりあえず、需要がかなり高そうな本なので、親戚や知り合いにおすすめしようと思ってます。
献本いただいた講談社さん、カレーさん、からあげさん、ありがとうございました!
そして、ここまで読んでくれた方、ありがとうございます!
ではまた〜
yukiCup 2023 Autumn× atmaCupに参加した
どうも、223です。今回は11/25に参加したyukiCup 2023 Autumn× atmaCupに参加したので、ちょっとだけ感想などを書きます。本当にちょっとだけですので、気になる方はguruguru上でディスカッションなどをご覧ください。www.guruguru.science
atmaCupは神
自分はコンペにフルコミットしたのが、学生限定atmaの時のみでしたので、今回のコンペが2度目のフルコミットしたコンペでした。開催時間は8時間程度と短く、フルコミットしやすいコンペ設計でした。とりあえず、atmaCupは初心者にとっての神コンペですので、初心者の方は参加しましょう。(12/8からコンペありますよ!)
コンペの結果
自分はpublic11位、private43位と32位shake downという惨劇で終了しました。ただ、個人的にはコンペ時間中にpublicの順位を上げる成功体験を積めたので、かなり満足してます。Private Bestを提出していればPrivate8位でしたが、「これを選べばよかった、、」と言えるようなSubでもなかったので潔く昇天しました。


感想
まとめて文章にするのが面倒なので、箇条書きで書きます。すみません。笑
- Cat Boostが有効らしく、今度のコンペで脳内選択肢がLightGBMに加えて1つ増えた
- これが効いた!という特徴量エンジニアリングが少なかったのが少し残念
- データのこういう傾向からこういう特徴量エンジニアリングが効く!みたいな話があったらもっと面白かった
- 初心者でもディスカッションを投稿して良い雰囲気作りはatmaの魅力だと改めて思った
- 緑の画面、久しぶりに見ると気持ちよかった
- 飲み会とボードゲームが楽しかった(ボードゲームは買った)
終わりに
次回のatmaCupは卒論締切間近なので、しっかり参加するのは厳しそうですが、その次のatma, yukiCupはフルコミットで参加したいと思えるようなコンペでした!トミーさん、yukiさん、gotoさん、スペシャルセンクス。
Write Code Every Dayが良い話
agenda
はじめに
こんにちは。おじろです。
今日は今年に入って始めたWrite Code Every Dayに関して共有しようと思います。
中々良さげなので皆さんもぜひ。
Write Code Every Dayとは
簡単です。毎日コードを書くことです。
自分はこの言葉(?)をソフトウェアエンジニアとしての姿勢と心構え @t_wadaで知りました。
「毎日〜を行う」というのは習慣にしやすいし、自分は圧倒的に実装力が足りていないのでコードを書く習慣をつけるために取り組もうと思いました。
上記の資料を見てもらうとすぐわかりますがここでも簡単に説明をしておきます。
4つのルールを守ることがWrite Code Every Dayです。少なくとも私はそう認識しています。
1. 毎日コードを書くこと
2. 意味のあるコードを書くこと
3. 深夜24時前に終わらせること
4. 書いたコードをGitHubで全てOSSにすること
この4つのルールを毎日守ることがWrite Code Every Dayです。
詳しくはt_wadaさんの資料を確認してください。Write Code Every Day以外にも有益なことがいくつも紹介されています。
ソフトウェアエンジニアとしての姿勢と心構え @t_wada
何を書いてる?
ルールを知って、始めよう!となったところで、何を書くかを考えました。
書きたいものや作りたいものがあるのならば良いのですが、自分はありませんでした。
自分のようにやりたいこと、作りたいことがない方は参考にしてください。
AtCoder
一番多く書いているのはAtCoderです。
レートを上げる、コーディングテスト対策など色々な目的を持っている方がいると思いますが、「問題を与えられて解く」というお題が与えられているので、何を書くか迷う方は競プロをやるのが良いと思います。
自分はこの習慣を始めて以降のコードをGitHub上にcommitしているので、ぜひ覗いてください。(クソコードばかりなので恥ずかしいですが)
Twitter分析
次に自分がやったのはTwitter分析です。
おそらくこの記事にTwitterから来ましたよね?(99.8%はTwitterからのアクセスです)
なら、Twitterのデータで遊ぶのも選択肢の一つです。
自分が行った分析(?)は記事にしているので参考にして遊んでください。
言語処理100本ノック
最後に100本ノック系ですね。
こちらもAtCoderと同様、問題が与えられるのでお題を考えなくて済みます。
自分は自然言語処理に興味があるので言語処理100本ノックを解きました。
Python関係の「○○100本ノック」のまとめに色々な100本ノックが掲載されているので、そこから探すと良いと思います!
自分が感じた効果
気になる効果ですが、めちゃくちゃ実装力が上がった!とかはないです。
まあ大したこともやっていないのに、1ヶ月で飛躍的に上がるはずもないです。
大きく3つですね。
- 毎日コードを書く習慣ができた
- AtCoderのレートが上がった
- NNの実装が手に馴染んできた
たったの一ヶ月でこんなに効果あるのなら、一年後は天才!?とか思います。
ぜひ皆さんも試してみましょう。
難しいところ
ただ、個人的に難しいと言うか、問題点は学校の課題などGitHubにあげられないコードを書いた時に記録がつかないことです。
GitHub以外で記録をとれば済むのですが、草が生えている「草を生やした」ことや、GitHubに記録として残ることの達成感でモチベが段違いです。
解決策を探しています。(むしろこのくらいしか問題点ないです)
今後やりたいこと
最後に今後やりたいことを少し書きます。
真似していいですよ(笑)
- kaggle極意本
- こちらは既に少しだけやってます(笑) GitHub Repository
- ただ就活中なのでコーディング対策も兼ねてAtCoderを優先しています
- Django
- 就職or院進先が決まったら色々作りたい
- 機械学習エンジニアのためのTransformers
- こちらも就職or院進先が決まったらここのコードを使って色々作りたいです
就活、院試対策中で色々やりたいことが溜まっていく、、、
はやく進路決まってほしいですね(雑談)
終わりに
とりあえず、毎日コード書きましょう。
自分は意外と3日くらいで習慣化しましたので、そこまで大変なことではないと思います。
実装力つけるために頑張るぞ〜。就活、院試頑張るぞ〜。
自分のTweetをWordCloudで可視化(形態素解析、固有表現抽出)
こんにちは。おじろ(@ozro_223)です。
今日は自分のTweetをTwitterから取得して、前処理、形態素解析、固有表現抽出を行なってWordCloudで可視化する流れを紹介します。
自分のtweetを文字列でみると恥ずかしさのあまり○ぬことがあるので、ご注意ください
データの取得
Twitter apiを利用する方法もあると思いますが、自分はこの記事を参考に自分のtweetが格納されているtweets.jsを取得しました。
実装
データの読み込み
まず初めに、データの読み込みを行います。
今回、環境としてはGoogle Colabratoryを使用しました。
まず初めに先ほど取得したtweets.jsを読み込むと、tweetの情報以外にも色々な情報が含まれていることがわかります。よって、tweetした内容のみを抽出します。以下のコードは同様の処理をしている記事と、shoku-panさんの記事を参考にさせていただきました。
with open('data/tweets.js') as f:
    data = f.read()
# 参考: https://oku.edu.mie-u.ac.jp/~okumura/python/tweetdata.html

import json
from dateutil.parser import parse
from pytz import timezone

tw = json.loads(data[data.find('['):])

text_list = []
for t in tw:
    full_text = t['tweet']['full_text']
    created_at = t['tweet']['created_at']
    text_list.append(full_text)
試しに、text_listの中身を見てみるとこのようになっています。
print(f'直近のツイート5件: \n {text_list[:5]}')
#['RT @johannyjm1: AI作曲のコンテストを開催します🙌🙌\nチェックしてくれ!!!!!🥳🥳🥳🥳🥳🥳', '足元ヒーターが機能してない寒さ', 'Twitterのデータ全然届かないな', '暖房入れても室温上がらん\n興奮してきた', 'さむい']
初っ端から自分のツイートではなく@johannyjm1さんのtweetですね。また、読み込み方法が悪いからか、ところどころツイートが抜けている気がしますが、厳密な分析をするわけではないので一旦スルーします。
RT情報は必要ないので、一旦元データを眺めてどのような前処理をするかを考えます。
with open('output/original_data.txt', mode='w') as f:
    f.write('\n'.join(text_list))
前処理
データを見てみると

のように表示されるRTと

のように表示されるリプライがあります。
そのほかにも引用リプライやurl、画像を挿入した時に出てくる

のようなhttpsから始まるような文字列も不要なので削除します。
@から始まるリプライは個性が出ると捉えられるので残そうか迷いましたが、一旦消します。
import re
import unicodedata
def preprocess_tweet(text):
    #改行されることによって一部が前処理されない状態になるのを防ぐ
    text = text.replace('\n', '')
    text = re.sub('@.+', '', text)
    text = re.sub('http.+', '', text)
    text = re.sub('RT.+', '', text)
    #日本語は半角全角が混合しているので整理
    #参考:https://tex2e.github.io/blog/python/unicodedata-normalize
    text = unicodedata.normalize('NFKC', text)

    return text

preprocecced_text = [preprocess_tweet(tweet) for tweet in text_list]
preprocecced_text = [tweet for tweet in preprocecced_text if tweet != '']
形態素解析
今回はWordCloudなど色々使って可視化したい、ということで単語に分割します。
今回は文分割を行いませんが、行う場合はpysdbがオススメです。
今回はSudachiのPython版SudachiPy という形態素解析ツールを使用します。
%pip install sudachipy sudachidict_core

from sudachipy import tokenizer
from sudachipy import dictionary

tokenizer_obj = dictionary.Dictionary().create()
- Sudachiにおいて、単語分割の分割基準は以下の3種類があります。
- A: 短単位
- B: 中間
- C: 固有表現相当
Aが一番細かくて、Cが一番大雑把という感じです。
正直どれが一番いいかわからないので、それっぽい文章で全部試してみます。
mode_a = tokenizer.Tokenizer.SplitMode.A
mode_b = tokenizer.Tokenizer.SplitMode.B
mode_c = tokenizer.Tokenizer.SplitMode.C

test_tweet = preprocecced_text[9] # 【悲報】この時間に黒子のバスケ、決勝突入。夜更かし不可避
result_a = [m.surface() for m in tokenizer_obj.tokenize(test_tweet, mode_a)]
result_b = [m.surface() for m in tokenizer_obj.tokenize(test_tweet, mode_b)]
result_c = [m.surface() for m in tokenizer_obj.tokenize(test_tweet, mode_c)]

print(f'result mode A: {result_a}')
print(f'result mode B: {result_b}')
print(f'result mode C: {result_c}')

#result mode A: ['【', '悲報', '】', 'この', '時間', 'に', '黒子', 'の', 'バスケ', '、', '決勝', '突入', '。', '夜更かし', '不可避']
#result mode B: ['【', '悲報', '】', 'この', '時間', 'に', '黒子', 'の', 'バスケ', '、', '決勝', '突入', '。', '夜更かし', '不可避']
#result mode C: ['【', '悲報', '】', 'この', '時間', 'に', '黒子', 'の', 'バスケ', '、', '決勝', '突入', '。', '夜更かし', '不可避']
えー、まさかの完全一致.
他の文章でも試したましたが、A, B, Cどれも一致しました。
異なる例は以下のようになります。(SudachiPyから引用)
# 複数粒度分割

mode = tokenizer.Tokenizer.SplitMode.C
[m.surface() for m in tokenizer_obj.tokenize("国家公務員", mode)]
# => ['国家公務員']

mode = tokenizer.Tokenizer.SplitMode.B
[m.surface() for m in tokenizer_obj.tokenize("国家公務員", mode)]
# => ['国家', '公務員']

mode = tokenizer.Tokenizer.SplitMode.A
[m.surface() for m in tokenizer_obj.tokenize("国家公務員", mode)]
# => ['国家', '公務', '員']
Cで十分ですね。Cで処理しましょう。
splited_text = []
for tweet in preprocecced_text:
    result = [m.surface() for m in tokenizer_obj.tokenize(tweet, mode_c)]
    splited_text.append(result)
print(splited_text[0])
#['足元', 'ヒーター', 'が', '機能', 'し', 'て', 'ない', '寒', 'さ']
試しに単語を数えてみましょう。こういう時に競プロでよく用いるdefaultdictが便利ですね。
from collections import defaultdict
word_dict = defaultdict(int)
for para in splited_text:
    for word in para:
        word_dict[word] += 1
#上位10位を表示
print(sorted(word_dict.items(), key=lambda x: x[1], reverse=True)[:10])
#下位10位を表示
print(sorted(word_dict.items(), key=lambda x: x[1])[:10])

#[('の', 3264), ('て', 2385), (' ', 2101), ('に', 1912), ('で', 1844), ('た', 1733), ('が', 1469), ('か', 1141), ('し', 1116), ('、', 1105)]
#[('足元', 1), ('ヒーター', 1), ('室温', 1), ('さむい', 1), ('片付か', 1), ('カッフェ', 1), ('MoT', 1), ('コネヒト', 1), ('Kanmu', 1), ('語る', 1)]
WordCloudで可視化
WordCloudで可視化を行ってみましょう。
# 日本語フォントをダウンロード
!apt-get -y install fonts-ipafont-gothic

from wordcloud import WordCloud
import matplotlib.pyplot as plt
%matplotlib inline
import random

def create_word_cloud(word_seq):
    res = WordCloud(
        font_path = '/usr/share/fonts/truetype/fonts-japanese-mincho.ttf',
        width=800, height=600, background_color='white',
        #regexp=r"[\w']+"
    ).generate(word_seq)
    plt.figure(figsize=(10, 8))
    plt.imshow(res)
    plt.axis('off')
    plt.show()

text = []
for para in splited_text:
    text += para
random.shuffle(text)
text = ' '.join(text)

create_word_cloud(text)
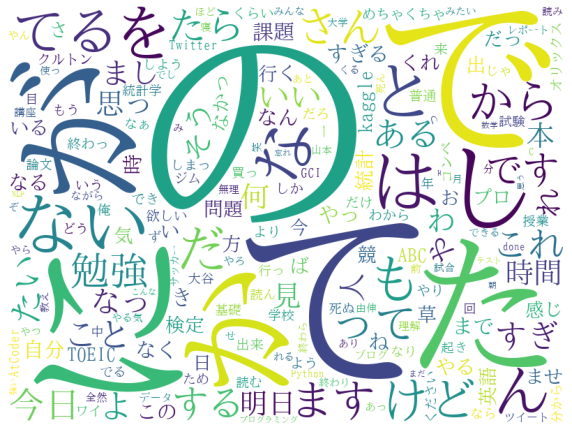
予想通りですが、「の」とか「が」とか機能語ばかりで全然面白くないですね。
WordCloudの引数としてstopwordsがあり、リストとして表示して欲しくない単語を渡すと表示せずに出力してくれます。
ただ、今回は品詞解析や固有表現抽出を行い、これらを改善したいと思います。
品詞解析
品詞解析と章立てをすべきか分からないほど、簡潔に行います。
機能語を消すために名詞のみを抽出して可視化したらいい感じになりそうだと考え、名詞のみを取り出して単語と同時に格納するコードを書きます。
品詞解析はsudachipyで可能です。
# 単語と品詞のタプルをリストに格納

word_pos = []
for para in preprocecced_text:
    for m in tokenizer_obj.tokenize(para, mode_c):
        word_pos.append(
            (m.surface(), m.part_of_speech()[0])
        )
print(preprocecced_text[0])
print(word_pos[:9])
#足元ヒーターが機能してない寒さ
#[('足元', '名詞'), ('ヒーター', '名詞'), ('が', '助詞'), ('機能', '名詞'), ('し', '動詞'), ('て', '助動詞'), ('ない', '助動詞'), ('寒', '形容詞'), ('さ', '接尾辞')]
以上のように品詞、単語を格納したので名刺のみを取り出して可視化してみましょう。
#名詞のみをwordcloudで可視化
nouns = []
for (word, pos) in word_pos:
    if pos=='名詞':
        nouns.append(word)
create_word_cloud(' '.join(nouns))

いい感じですね。めちゃくちゃ勉強してる人みたいになってますね(笑)
全然やってないkaggleや統計検定が入っていて、WordCloud上では優秀に見えます。
固有表現抽出
最後に固有表現抽出を行なって可視化してみましょう。
日本語解析ライブラリのGiNZAを用いて解析を行い、固有表現を抽出します。
ホームページ
論文
%pip install -U ginza ja_ginza_electra

import spacy
from ginza import *

nlp = spacy.load('ja_ginza_electra')
# from https://ja.wikipedia.org/wiki/Twitter_(%E4%BC%81%E6%A5%AD)
text = 'Twitter, Inc.は、カリフォルニア州サンフランシスコを拠点とする、アメリカ合衆国のIT企業である。'
doc = nlp(text)
spacy.displacy.render(doc, style='ent', jupyter=True) #entity->固有表現

たしか220種類くらいタグがあって、可視化も今回は全部灰色ですが、カラフルです。
では固有表現を抽出して可視化してみましょう!
# 30分かかる
ent_dict = defaultdict(int)

for doc in nlp.pipe(preprocecced_text):
    for ent in doc.ents:
        ent_dict[ent.text] += 1

ents = []
for ent_text, count in ent_dict.items():
  ents += [ent_text] * count
random.shuffle(ents)

create_word_cloud(' '.join(ents))
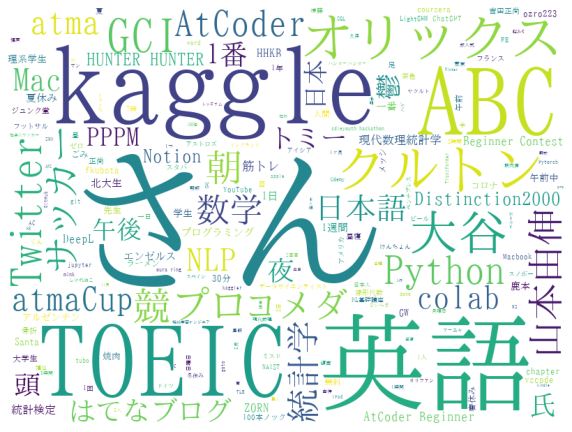
さんって固有表現なんですね(?)
だいぶいい感じになりました。kaggleやTOEIC、英語など自分が全然できないものが大きく表示されていますね。これは何でだろう?(笑)
また、自分が好きな野球に関係するオリックス 山本由伸 大谷なども出てきてますね。
Twitterのアカウント名ではクルトンさん(@kuruton456)さんが大きく表示されていますね。クルトンさんのファンなのかもしれない。
終わりに
最後まで見ていただきありがとうございます。
WordCloudだけでなく@takapy0210さんのnlplotなどで可視化しても色々と発見があるかもしれません。
今回用いたコードはNAIST DSC summer seminarで用いられたコードを参考にさせてもらっています。
有料ですが値段以上に有益なことが多かったので来年も参加しようと思います。
今回用いたコードはgithub上で公開しますので、ご自由にいじってください。
またモチベーションが高まったら色々いじってみようと思います。
ありがとうございました〜。
[追記]
Qiitaにも同じような内容を投稿しました。
Qiitaには真面目なブログ、こちらはつぶやきブログとして運用していこうと思います。
AtCoder茶色になりました。(Python)
えー、AtCoder茶色になりました。
 誰かの役に立てばと思い、役に立ったサイト、本などを書いていきます。
先に一番大事なことを言いますが、茶色になるために一番大事なのはモチベです。
モチベない人は誰かと一緒にやるのがいいです。ぼっちは辛い。
1. 茶色になるためにやった勉強法
どうやって学ぶのかが一番気になるところだと思いますので、紹介していきます。
茶色になるために必要なスキル、勉強ロードマップはE8さんの記事にまとまっているので、そちらをご覧ください。
自分がやったのは主に2つです。
鹿本(~中級)
https://amzn.asia/d/3CuNBpE
競プロ入門最強書籍です。競プロが気になるなら買いましょう。
自分はまだ中級までしかやっていません。上級までやっていたらもっと早く茶色になっていたと思います。
とりあえず2022年買った本で一番自分の役に立った本です。買って損はしないと思います。
AtCoder ProblemsのTraining
AtCoderの問題を解きたいな〜と思った時に解いてました。 AtCoder Problems
Easyは「すぐに解けるように」、Mediumは「80%以上の確率で解けるように」という感覚で解いてました。
向上心を持ってHardなどをもっと解いてたらもっと早く茶色になっていたと思います。サボってました。
自分のようにEasyを100問解く必要は絶対にないです。30問くらい解いたタイミングでMediumを解いた方がいいです。

2. お世話になったサイト
ここでは死ぬほどお世話になったサイトや本を紹介していきます。感謝!!!!
鹿本
https://amzn.asia/d/3CuNBpE
正直この本やってコンテスト出てれば余裕で茶色になれますし、それが最短ルートです。上級もちゃんとやります、、、
AtCoderに興味あるなら今すぐAmazonでポチってください。
自分がお世話になったサイト
Python TimeComplexity
Pythonの計算量について書いてあるところです。for文の中で、in listとか使わないように。
AtCoder Problems
過去問とか色々解けます。おすすめはTrainingをひたすら解くこと。
このサイトがない世の中を考えられません。作成者の方にノーベル賞あげてください。
けんちょんの競プロ精進日記
ABC, ARCの問題を丁寧に解説されています。何度もお世話になりました。
AtCoder緑色になりました
カレーちゃんさんのBlogです。環境構築や緑になるまでにやってきたことなどが書かれていて参考になりました。
AtCoder Rating Estimator
ここに茶色のレーティングを入れてコンテスト前にモチベをあげてました。モチベが大事。
AtCoder Easy Test v2
これがないとAtCoder辞めてた!というくらい便利です。
以下のように提出する際にテストケースを試してくれます。ペナルティくらうのをできるだけ避けることができます。

その他便利な拡張機能がたくさんあります。このサイトにたくさん拡張機能が載っているので、便利だと思ったら入れてみましょう。
自分の課題、今後の目標、予定
課題
課題は明確で、アルゴリズム知識、実装力がないことです。
これのせいで、D問題が90%解けない状態になっています。これが入茶するのに時間がかかった理由ですね。
体系的に学んだのが鹿本の中級までで、あとは問題を解いていただけという状態です。ですので、鹿本の上級、鉄則本などを進めてアルゴリズム力を鍛えたいと思います。
今後の目標、予定
自分は大学生のうちに入緑したいと思っています。
とはいえ、院試や就活、インターンなどで夏前はまとまった時間が取れそうにないので、夏までは1日1ACでコンテストにできるだけ参加していこうと思います。
今でも600パフォくらいまでは出ているので、600付近までは参加しているだけで上がりそうな感じもします。
夏以降は鹿本、鉄則本を解きまくって一気に入緑したいです。
おわりに
まあ、AtCoderは楽しいです。
レートはコンテストに出続けるメンタルがあればある程度までは簡単に上がると思っていいと思います。
ただ、そのメンタルを持つことが一番難しいと自分は思います。
緑まで頑張るぞ〜
言語処理100本ノック解いた
言語処理100本ノックを解きました。(2, 5, 10章はSKIPしてます.)
はじめに
解答解説はネットに山ほどあるので、特に触れるつもりはありません。
ただ、一部昔と変わっていて動かないコードもあるので自分のコードが役立てば幸いです。
Github NLP-100knocks
感想
解いたからと言って書けるようになったわけではありません。
ただ、わからない問題を写経->読めないところのdocumentを眺めることで前よりは書けるようになった(気がします)
また、競プロで養われたコーディング能力はとても役立ちました。1章は競プロやってたおかげでスラスラ解けました。競プロは役にたつ。
正規表現はある程度理解しましたが、複雑になると理解できなくなります。まーじで暗号ですやん。
あと、学習済み単語ベクトルは重くて読み込めませんでした。Colab強化してください。
オススメサイト
解答として参考にしたBlogを2つ貼っておきます。
u++ さんの「言語処理100本ノック 2020」をPythonで解く
Amaruさんの【言語処理100本ノック 2020】Pythonによる解答例まとめ
解く際にPython, PyTorchの知識はあった方が良いと思うので以下をオススメします。
Python チュートリアル(ja)
PyTorch チュートリアル(ja)
2022良かった本(技術書, ビジネス書...etc)
もう2022年も終わりますね(定型文)
今年読んだ本の中で個人的に良かったものを紹介します。Amazon、実店舗合わせて50冊ほど買ったと思います。ここで勘違いして欲しくないのは50冊は読んでないです。半分くらいは買って、めくって、本棚に積んであるだけです。改めて考えると悲しいです。
- アルゴリズム的思考力が身につく! プログラミングコンテストAtCoder入門(鹿本)
- エッセンシャル思考 最少の時間で成果を最大にする
- 深層学習 改訂第2版 (機械学習プロフェッショナルシリーズ)
- TQ-心の安らぎを得る究極のタイムマネジメント
- 本質を捉えたデータ分析のための分析モデル入門
- 進化しすぎた脳―中高生と語る「大脳生理学」の最前線
- おわりに
アルゴリズム的思考力が身につく! プログラミングコンテストAtCoder入門(鹿本)

これはけんちょんさんが書いたAtCoder入門書です。これはマジで神本でした。恐らく、AtCoder初心者〜茶色までは問題を解きまくるのが一番の近道だと思うのですが、この本は典型問題の解説、解き方のコツを紹介し、類似問題をたくさん紹介してくれるというAtCoder上達最短経路へ導いてくれる神本です。「AtCoderやりたい〜」「 AtCoderどう進めればいいのかわからない」という人は今すぐ買いましょう。
ちなみに今年発売されたE8先生の「競技プログラミングの鉄則(鉄則本)」も神本間違いなしですが、まだあまり読めていないので今回は入っていません。個人的な感覚としては鉄則本は入門書ではなく、入茶した人がアルゴリズムを学んでさらにレベルアップしたい時に使う本だと思っています。鹿本->鉄則本の順でやれば緑くらいまではスーっと行くと思っています。
(参考)
エッセンシャル思考 最少の時間で成果を最大にする

これも良かったです。簡単にいうと、やりたいこと・やることを絞れという話なんですが、めちゃくちゃ面白かったです。帯に某メンタリスト推薦!とか某Youtuber推薦!とか書いてあって読む気を完全に無くしてたのですが、読んで良かったです。あの帯やめような。
深層学習 改訂第2版 (機械学習プロフェッショナルシリーズ)

青本の第2版です。発売された時はめちゃくちゃ話題になりました。この厚さ・内容で3300円!?!?と驚くばかりです。深層学習でわからないところがあった時に辞書代わりとして使ってます。文句なしの神本。損しないので買いましょう。
個人的には他の書籍と比べて数式、説明の全てがわかりやすかったです。
TQ-心の安らぎを得る究極のタイムマネジメント

ほぼ自己啓発本ですが、めちゃくちゃ面白かったです。あまり説明することもないですが、時間ある人は買って読みましょう。いいですよ〜(適当)
本質を捉えたデータ分析のための分析モデル入門

はい、あのアイシアさんの(マスターの)本です。深層学習、統計モデル、強化学習の基礎をわかりやすく(わかりやすすぎる)学べる最強の一冊です。しかも、アイシアさんがつよつよデータサイエンティストなのもあって、実務でどう考えるか、使うかを解説してくれている数少ない本です。絶対損しないので買いましょう。てかこれも3300円か、、これが3300円なんて無料みたいなもんだよ。
買うか迷ったらアイシアさんのYoutubeを見てみるといいです。見たら買いに行くと思います。
進化しすぎた脳―中高生と語る「大脳生理学」の最前線

これはただ単純にめちゃくちゃ面白かったです。これ読んで認知科学系統に興味を持ってしまい、進路を悩み始めるレベルで面白かったです。興味ある人は絶対読んでください。続づきも出版されているので、来年読みます。
ここら辺のお話に興味ある人におすすめの記事
おわりに
こうやって見てみると、過去の自分から「お前は何を学んだ?」と耳元で囁かれている気分になります...。
2023年は本は積まずにちゃんと読みたいものです。
